AI学習は1ビットの違いでも別の結果に、約50万回の実験で再現性の限界を検証
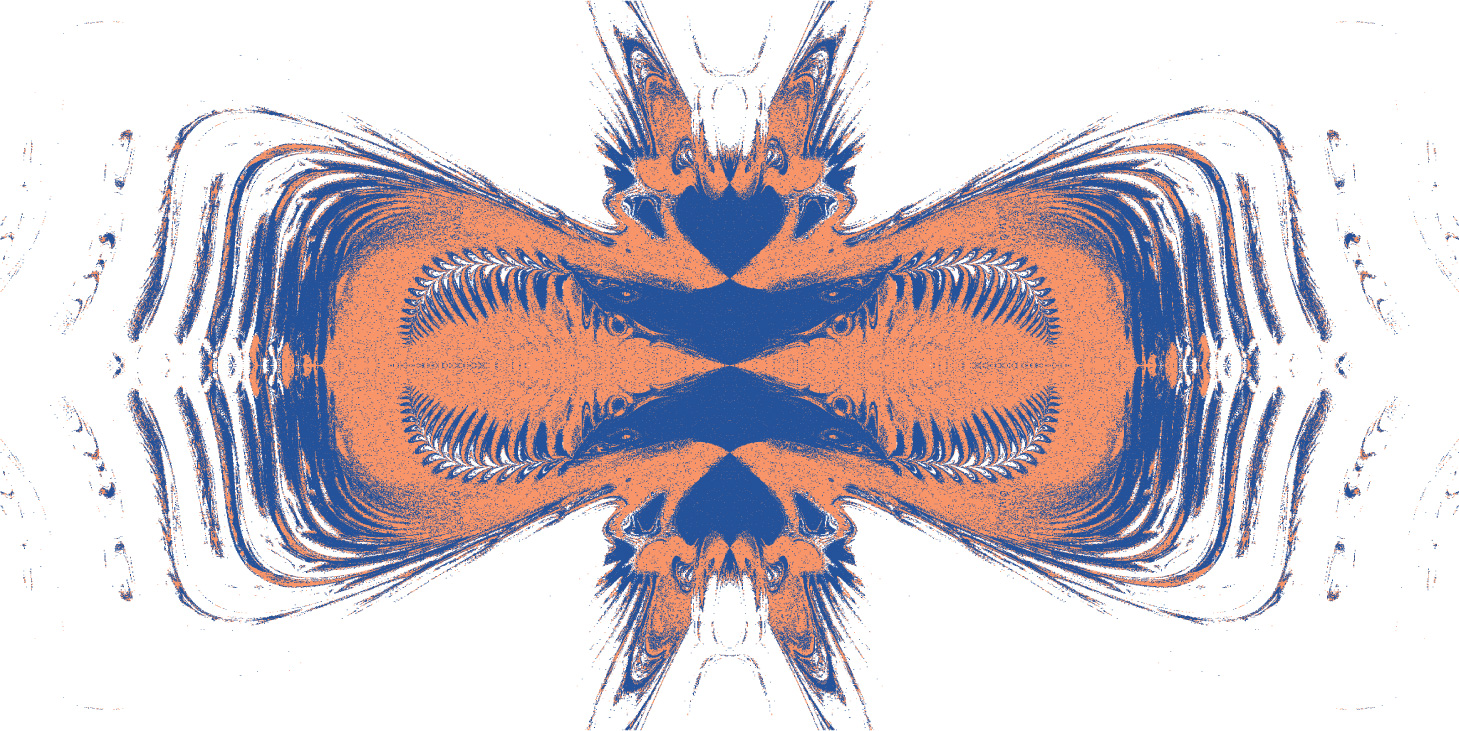
同じデータで同じようにAIを育てたはずなのに、なぜ違う結果になるのでしょうか。シドニー大学のAndrew Ly氏とPulin Gong氏は、ニューラルネットワークの出発点にあるごく小さな差に注目しました。
11月5日付のNature Machine Intelligence掲載研究を、大学が6日に紹介。約50万回のネットワーク学習を分析し、学習結果の分かれ道にフラクタル的な構造があるという証拠を示しています。
出発点を精密にすれば解決するとは限らない
学習の出発点を地図上の場所、最終結果を色と考えてみます。普通の地図のように境界がくっきり分かれていれば、場所を正確に決めるほど行き先も予測しやすくなります。今回扱う条件では、その色が細かなスケールでも入り組んでいました。
大学発表によると、ある画像認識ネットワークでは初期値を100億倍精密にしても再現性に測定可能な改善がなく、1ビットの変更で約48%が別の内部構成へ進みました。この48%は「AIの答えの48%が間違う」という意味ではありません。
学習の違いと、回答の違いを分ける
公開プレプリントでは、内部パラメータの違いと、実際の予測が食い違う割合を区別しています。代表的な実験の予測不一致率は約2.9%で、内部構成の差とは別の指標です。これは査読版に先立つ版の値である点にも注意が必要です。
同じ初期条件と決定論的な計算を完全に再現できれば同じ結果になることと、わずかに違う初期条件に敏感であることは矛盾しません。また、学習済みチャットAIに同じ質問をした際の出力の揺らぎを直接調べた研究ではありません。すべてのAIが制御不能だとする結論でもありません。
世間の反応
一般読者の反応を代表する情報は確認できていません。大学発表は、精度だけでなく再現性を測ることが、信頼できるAIの設計に必要だと位置づけています。
出典
- Nature Machine Intelligence(査読論文): https://www.nature.com/articles/s42256-026-01336-3
- University of Sydney(公式発表): https://www.sydney.edu.au/news-opinion/news/2026/11/06/sydney-researchers-uncover-a-hidden-limit-to-ai-predictability.html
- arXiv(公開プレプリント第2版、査読版との差に注意): https://arxiv.org/html/2510.05606v2
- Phys.org(研究紹介): https://phys.org/news/2026-11-fractal-patterns-reveal-hidden-limits.html
おもせかの一言
「同じように作る」と「同じものができる」の間には、思った以上に細かい分かれ道がありました。